GFS 笔记
GFS 是什么:大规模可扩展容错的分布式文件系统
具有的特性:
- 容错:组件失效被认为是常态事件,而不是意外事件
- 运行在普通机器上:GFS包括几百甚至几千台普通的廉价设备组装的存储机器,同时被相当数量的客户机访问
- 大文件数据处理:以通常的标准衡量,我们的文件非常巨大。数GB的文件非常普遍。
- 在尾部追加数据是最常见的:绝大部分文件的修改是采用在文件尾部追加数据,而不是覆盖原有数据的方式。对文件的随机写入操作在实际中几乎不存在。一旦写完之后,对文件的操作就只有读,而且通常是按顺序读。
- 应用程序和文件系统 API 的协同设计
- 能够高效、行为定义明确地实现多客户端并行追加数据到同一个文件
接口
类似传统文件系统 API。文件以分层目录的形式组织,用路径名来标识。我们支持常用的操作,如创建新文件、删除文件、打开文件、关闭文件、读和写文件。
重要接口是:快照和记录追加操作(Snapshot and AppendEntriyes)
架构
GFS 集群由一个 master 多个 chunkserver 以及多个 clients 构成。上述的每一个成员都是以用户态进程的形式运行在普通的 Linux 机器上。允许 chunkserver 进程和 client 进程运行在同一台机器上。
文件被分片成固定大小的 chunk,每个 chunk 都有一个 64bits 的全局唯一可不变的 chunk handle 来标识,这个 chunk handle 是chunk 被创建的时候,master 分配的。 chunks 存储在某台机器的本地磁盘中,以 linux 文件格式的形式组织。通过 chunk handle 以及字节范围来读写 chunk;为了可靠性,每个 chunk 都在 3 个不同的机器上有备份。
master 维护了整个文件系统的元数据。master 通过心跳包周期性地与每一个 chunkserver 通信,给它们发送指令并收集它们的状态。
数据流。client 和 master 通信只是想要获取元数据,真正的文件数据是直接向 chunkserver 获取的。
clients 和 chunkserver 都不缓存文件数据。因为 GFS 处理的一般都是大文件,并且一般都是 stream 读的情况,缓存不了,缓存了也不一定会被再次用到。然而 clients 会缓存元数据。
client 的简单读的流程
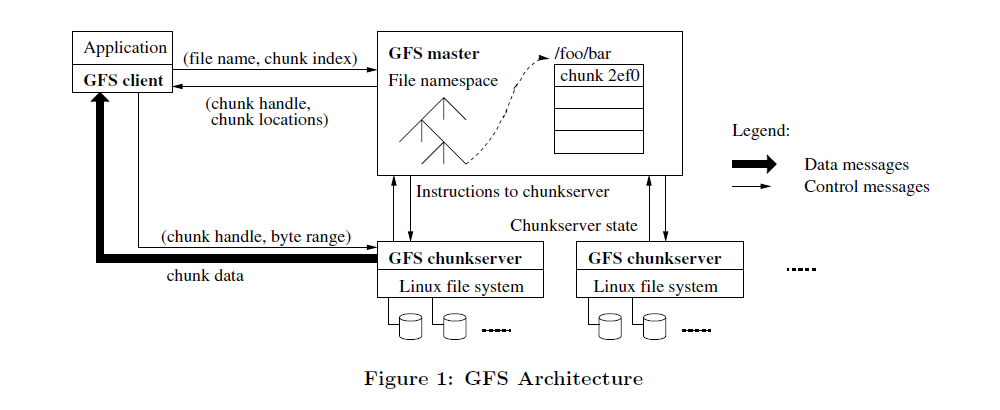
- 客户端给出想要读取的文件名 file name,以及 offset
- 根据固定大小的 chunk(64MB),得到 chunk index,然后将 (file name,chunk index)发送给 master
- master 查看自己的元数据,响应客户端,传回 (chunk handle,location of replicas)
- client 缓存 (chunk handle,location of replicas),把 (file name,chunk index)作为 key;缓存有效期内不必再询问 master
- client 从 location of replicas 中挑一个 replica (可能是物理位置最近的那个 replica),把(chunk handle,byte range)发给它
Chunk Size 固定成多大比较好?
论文中固定 chuck size = 64MB
chuck size 的选择是至关重要的,为什么选择 64MB?这个数远远大于 OS 页帧大小;
选择大的 chuck size 是有好处的:
chuck size 大了,整个文件所对应的 chuck 的数量就少了,这样客户端就能轻易缓存好几个 TB 大小的文件的 chuck handle 以及对应的 location,这样就可以减少跟 master 的交互,降低 master 的压力(只要缓存不过期,就不需要询问 master 了),这一点可以归结为 chuck size 越大,元信息越少;
这一点直接使用了第一点的特性即 chuck size 越大,元信息越少,因为元信息少,master 可以把全部的元信息直接放在内存上,加快访问速度;
由于是使用一个大的chunk,客户端可以在一个chunk上完成更多的操作,它可以通过维持一个到chunk server的TCP长连接来减少网络管理量(overhead,负载?)
选择大的 chuck size 也有坏处:
在小文件的情况下,会出现热点问题;如果一个文件很小,不到 64 MB,那么只有一个 chuck,加上备份的,那么总共三台 Server 存储了这个 chuck,如果此时有大量客户访问这个文件,那么这三台 Server 就变成了热点,立马有成百上千的并发访问到达,服务器立刻就超载了。
怎么解决因为小文件引起的热点问题?
- 提高备份级别(多备份几份,原来是有 3 份,那么现在可以搞成 10 份)
- 不要让很多客户端在一个时间段能同时并发访问,把访问时间隔开
- 使用 P2P 的方式
元数据
master 维护了三种元数据:
- file/chunk namespace
- 从 file 到 chunks 的映射关系
- 每一个 chunk 及其副本的位置
所有元数据都保存在 master 的内存中,前两种元数据需要通过 WAL 的方式持久化存储,并做远程备份(replication)。第三种元数据,是 master 询问 chuck server 得到的。使用 WAL 可以抵御因 master crash 导致的数据不一致的风险。
metadata 保存在内存中的好处:
- 访问内存比访问磁盘快多了
- 有利于 master 后台线程周期性地扫描整个状态
- 周期性的扫描可以方便的进行:chunk 垃圾回收,重复制,在 chunkserver 之间进行 chunk 迁移来实现 负载均衡 和 磁盘空间使用率的均衡
唯一潜在的问题:单台机器的内存有上限
为什么 master 不用持久化保存 chunk 所在的副本位置的信息?
操作日志 Operation Log
操作日志保存了关键元数据变化的历史记录。它是 GFS 的核心。
操作日志是整个系统的逻辑时间,定义了并行操作的顺序。
日志被持久化之前,对于客户端来说不可见。因为此时的数据是不可靠的(还没有持久化可能会丢失)
日志压缩方式:异步 checkpoint 其实也就是 snapshot
Q: 如果在制作 checkpoint 的时候发生故障怎么办?这是没有问题的。因为我们每一次修改日志都会做持久化,制作 checkpoint 时发生故障,无非就是不理会这个没有完成的 checkpoint,重放日志记录就可以恢复到故障前的状态了;
GFS 的一致性是怎么实现的?
首先 GFS 支持的一致性是什么?
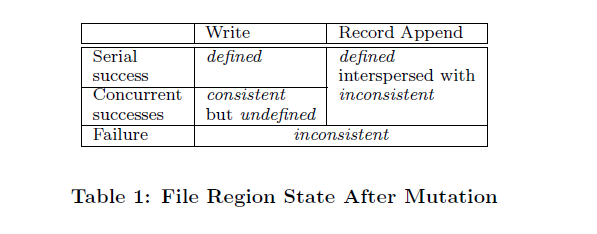
GFS 支持宽松一致性,从下图就可以看出;
对于这个表格需要注意的是 Write 指的是 in-place write;Record Append 指 append write;defined 和 consistent 针对的是文件的某一个数据区域而言的,不是针对整个文件数据;
consistent:无论从哪个副本读,所有 clients 看到的文件区域中的数据都是一样时,这个文件区域具有一致性
defined:满足两个条件,1. 文件区域具有一致性;2. 所有客户端能够看到完整的变更;那么这个文件区域就是已定义的。
对于 defined 中完整的变更怎么理解?变更嘛,对于文件来说无非就三种,串行 in-place write,并发 in-place write,record append;你做变更的时候肯定要指定变更数据是不是?完整的变更就是指,一次变更结束后,你立马读那块区域的数据,读出来的数据就是你写进去的变更数据,而不是其他莫名其妙的数据。
- namespace 的变更是原子操作,WAL 保证全局操作顺序
- 成功的串行 in-place write 所操作的那块文件区域必定是已定义的
- 成功的并发 in-place write 所操作的那块文件区域是一致的但是未定义的
- record append 所操作的那块文件区域必定是已定义的,但是在它前面区域可能是不一致的
租约与变更顺序
GFS 使用租约机制来维护多副本的数据变更顺序一致性;除此之外,租约机制也大大减轻了 master 的负担,因为所有的写请求就不需要通过 master 而是直接通过 primary 就可以了;
- master 利用租约,保证在任意时刻,副本中至多只有一个 primary
- primary 将所有对 chunk 的变更操作标号排序,得到一个统一的变更顺序,然后让 secondary 按照这个顺序来应用变更
和 Raft 的区别:Raft 使用 Leader Election 来选举出一个集群中唯一的领导,然后把所有的读写请求作为日志记录通过领导复制给其他副本,达到多副本的数据一致性;而 GFS 则由 master 通过租约的形式来委任一个 primary,让 primary 给所有的变更规划一个统一顺序,然后让 secondary 按照这个顺序来应用变更来达到多副本数据一致;所以区别在于,Raft 是选举得到唯一的话事人,GFS 是通过租约得到唯一的话事人
其实从上述分析中可以得到 Raft 和 GFS 的共同点:都需要得到一个唯一话事人来规划一个统一的顺序
client 写的流程
client 写可以分成 7 个步骤,2 条数据流(控制数据和文件数据)
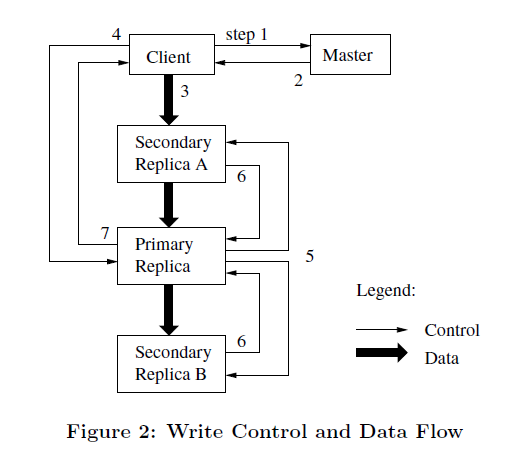
- client 询问 master,我要写的那个 chunk 所在的 primary chunkserver 是谁;如果 master 发现那个 chunk 对应的所有 chunkserver 没有一个持有租约,则找到最新的那个副本(master 会维护一个版本号来识别哪个副本是最新的),让他成为 primary
- master 响应客户端 primary 以及 secondary 的位置,客户端缓存这些信息直到租约过期或与 primary 失去联系
- client 把文件数据通过 pipeline 的方式推送给最近的副本,然后让那个副本同样用 pipeline 的方式继续推送文件数据;副本收到数据后,把数据缓存在 LRU Buffer Cache 中直到数据被使用或过期
- 一旦所有的副本都收到了数据并且响应 client 后,client 才会发送写请求给 primary。primary 给所有的数据变更(可能来自多个 clients)排一个序,然后根据顺序应用这些变更到自己本地状态机
- primary 将写请求转发给所有的 secondary,每一个 secondary 都按照相同的顺序应用变更到本地状态机
- secondary 响应 primary 表示应用变更成功
- primary 响应 client 。任何副本碰到的 error 都会返回给 client。 client 仅仅通过重试写请求来处理 error。它会首先在3-7步骤间进行一些尝试后在重新从头重试这个写操作
整个过程需要注意的点:
如果某一时刻某个 chunk 没有 primary,那么 master 怎么从所有的副本中找到最新的副本并给他租约?
- master 给每个 chunk 维护了一个版本号,只要副本中的版本号与 master 中所维护的那个一致,那么它就是最新的副本
为什么使用 pipeline 的方式推送数据?
- 使用 pipeline 的方式相当于是链式拓扑推送数据,一台机器只需要往外推送一次数据就可以了,减轻了网络带宽的负载;又由于不需要等待数据完全达到就可以继续往下传递,大大减少了延迟;
如果有某个副本突然下线,那么就不能收到数据并响应 client 了,此时 client 不能收到所有副本的响应,此时该怎么办?
primary 告诉所有的副本去执行数据追加操作,某些成功了,某些没成功,所以现在,一个 chunk 的部分副本成功完成了数据追加,而另一部分没有成功,此时读数据会发生什么?
此时读到的数据可能是最新的,也可能是旧的,取决于你读的是哪个副本;对于 GFS 来说,这种状态是可接受的,没什么需要恢复的;
那么如果我想要读到新的数据该怎么办?
如果一个写操作跨越了 chunk 边界怎么办?
- GFS 库会把这次写操作拆分成多次写操作;这样的坏处是,丢失了原子性,多次写操作中间可能会插入其他 client 的写操作,这样文件区域的状态处在一致但未定义(与并发写的结果一样)
原子记录追加
GFS 支持两种写,in-place write 和 append,对于前者,需要给出具体的偏移量,而后者只要给出数据就可以了。并发地 in-place write 是不保证串行的,因此结果可能是所写区域的尾部数据由多个 client 的数据的片段构成;因此并发的 in-place 写能保证一致性,但文件区域会处在一种一致但未定义的状态;
对于 append,GFS 保证至少原子地追加一次到文件末尾!
append 的整个流程和上述的 client 写的流程大差不差,只是 primary 需要多一个逻辑判断;如果 append 数据后超过了整个 chunk 的大小,那么 primary 会先填充完 chunk 中的剩余空间,然后告诉 client 让它向下一个 chunk 重新发起一次 append;当所有副本收到数据,并且 primary 肯定 append 不会导致 chunk 溢出后,就把 append 操作应用到本地,并且让其他副本也在相同的偏移位置(primary append 的偏移位置)应用这个 append 操作;最终所有副本都成功后,primary 响应 client,告知成功;一旦某一个副本没成功,primary 就会让 client retry;
append 操作的数据大小必须小于 chunk 的 1/4,也就是 16MB;
由于 append 有 atomically at least once 特性,那么 append 一定是已定义的(也包括了一致性),但是可能存在某些副本在 client 经过多次 append 请求后才真正进行 append,因此在 append 前的数据区域可能是未定义的。 例如:
1 | S0: a b b c d c |
snapshot
对于快照这一块,需要搞清楚:
- 快照是 master metadata 的快照,还是 chunkserver 中 chunk 的快照?
- 我认为是 master metadata 的快照,因为只有 metadata 这一块使用了 WAL 来保证一致性以及故障恢复;
- 快照使用了什么技术来让整个过程轻量化?
- 使用了 COW?怎么用的?
Master 的工作
master 干了以下工作:
- 所有涉及 namespace 的操作
- 对副本的放置做决定
- 创建新的副本以及 chunks
- 通过重复制保持 chunk 的复制级别
- 在 chunkservers 间进行负载均衡(网络带宽负载,磁盘使用率负载)
- 未使用空间的垃圾回收
如何保证 namespace 的变更是原子的?
对 namespace 的修改操作要求串行化执行,为了灵活性,采用读写锁,对目录加读锁,对文件加写锁。
每个 master 在执行操作之前都需要获得锁的集合,比如,如果它想操作 /d1/d2…/dn/leaf,那么它需要获得 /d1,/d1/d2……,/d1/d2…/dn 这些目录的读锁,然后才能得到路径 /d1/d2…/dn/leaf 的读锁或者写锁。
这种锁模式的一个好处就是它允许对相同目录的并发变更操作。比如多个文件的创建可以在相同目录下并发创建:每个获得该目录的一个读锁,以及文件的一个写锁。
- 目录名称上的读锁足够可以防止目录被删除,重命名或者快照。
- 文件名称上的写锁将会保证重复创建相同名称的文件的操作只会被执行一次。
加锁顺序很重要,可以有效避免死锁:锁是按照一个一致的全序关系进行获取的:首先根据所处的 namespace 树的级别,相同级别的则根据字典序。
副本放置的位置
chunk 的备份放置策略服务于两个目的:最大化数据可靠性和可用性,最小化网络带宽的使用。
论文中的做法是将备份放在不同机柜的机器上,这样既能做到机柜级别的容错,读取操作也能利用多个机柜的带宽;
chunk 的创建,重复制,重平衡
创建 chunk 的时机:
- 写操作可能需要新的 chunk
- chunk 的可用备份数低于用户设定的目标时,master 会进行重复制
- 周期性地重平衡
为 chunk 选择 chunkserver 时需要考虑:
考虑到平均磁盘使用率
chunkserver 上最近的 chunk 创建数或 clone 数
在不同机柜间放置
垃圾回收
懒回收机制
- 当应用删除文件时,master 先把该文件改名为隐藏文件,并标上时间戳
- master 会周期性地扫描文件系统的 namespace,会定期删除那些超过 3 天的隐藏文件
- 在类似的 master 扫描程序中,会检测 chunk namespace,如果发现了过期的 chunks(即那些没有相关联的文件的 chunks)则删除所有与之相关的元数据
- 在 master 与 chunkserver 的周期性心跳中,chunkserver 会报告自己所持有的所有 chunk handle,master 会查看自己所持有的所有 chunk handle,把那些已经删除的 chunk 的 chunk handle 通过心跳包传给 chunkserver,然后 chunkserver 就可以自己去删除它本地的 chunk 数据了
识别陈旧副本
对于每一个 chunk,master 都为其维护了一个 version number 来识别是否是最新副本。
master 每次在一个 chunk 上授权新的租约的时候,都会增加这个 chunk 的 version number;
master 和所有的副本都会记录这个最新的 version number,并持久化
如果另一个副本当前不可用,它的 chunk 版本号就不会被更新。当 chunkserver 重启或者报告它的 chunk 和对应的版本号的时候, master 会检测该 chunkserver 是否包含过期副本。
陈旧的副本会被 master 的周期性扫描程序通过垃圾回收的方式删除;
当 client 询问 master 关于 chunk 所在的 chunkserver 时,master 只会把最新的 chunk 所在的 chunkserver 告知 client;并且为了更加安全,每次 client 与 chunkserver 通信时都会通过 version number 再次确定 chunkserver 中的 chunk 是最新的!